lama.cpp 是本地大模型推理的事实标准,纯 C/C++ 实现、零外部依赖、支持 100+ 种模型架构与 1.5~8 位量化,截至 2026 年 8 月 GitHub Stars 已超 12.3 万,2 月正式并入 Hugging Face 体系,10 月新增决策模型接口,生态地位稳固。
项目定位
- 本质:由 Georgi Gerganov 于 2023 年 3 月发起的开源 LLM 推理引擎,最初目标是让 LLaMA 在 MacBook 上运行,现已成为覆盖手机到服务器的通用推理基础设施。
- 许可证:MIT,可商用。
- 仓库:2026 年 2 月从
ggerganov/llama.cpp迁移至ggml-org/llama.cpp,核心团队加入 Hugging Face,保持 100% 开源。 - 规模:截至 2026 年 8 月 Stars 超 12.3 万,贡献者超 1600 人,Ollama、LM Studio、GPT4All、LocalAI 等数十个工具均构建在其之上。
核心特性
- 零依赖:纯 C/C++ 实现,编译为单一二进制文件,无需 Python/PyTorch/CUDA 运行时。
- GGUF 格式:已成为本地 AI 推理的标准模型格式,Hugging Face 推理端点原生支持。
- 极致量化:支持 1.5-bit 至 8-bit 整数量化,7B 模型 Q4_K_M 量化后仅需约 5GB 内存。
- 多后端加速:CUDA(NVIDIA)、Metal(Apple)、Vulkan(跨平台)、ROCm/HIP(AMD)、SYCL/OpenVINO(Intel)、WebGPU。
- CPU+GPU 混合推理:模型超出显存时可分层卸载,部分在 GPU、部分在 CPU 运行。
- 模型覆盖:支持 LLaMA、Mistral、Qwen、DeepSeek、Gemma、Phi、GLM 等 100+ 架构,含 LLaVA、Qwen2-VL 等多模态模型。
- 语言绑定:Python、Go、Node.js、Rust、C#、Java、Swift 等数十种。
内置工具
| 工具 | 用途 |
|---|---|
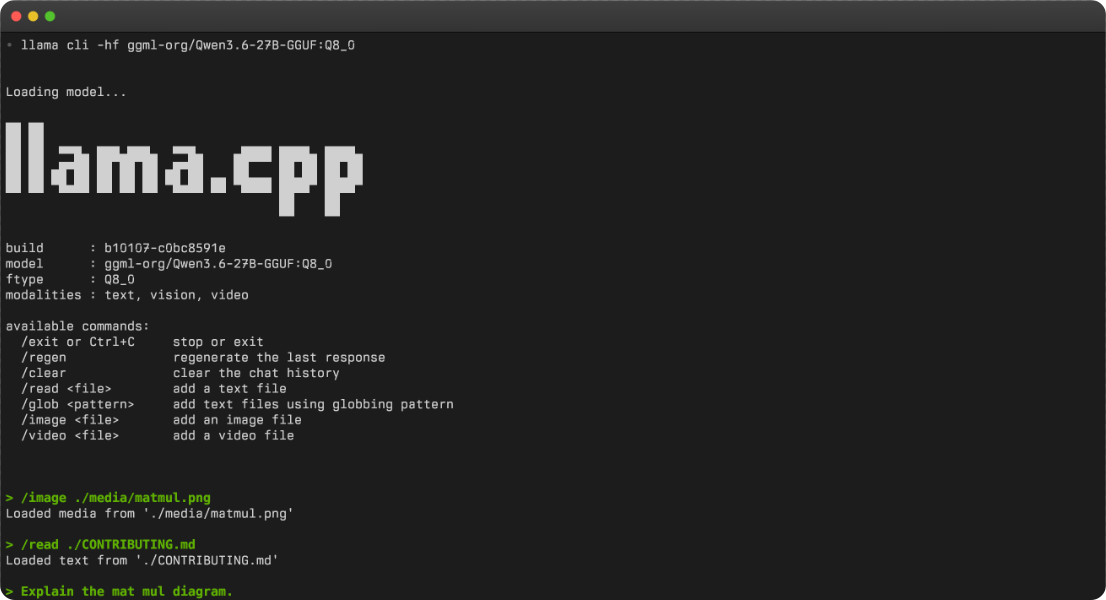
llama-cli | 命令行交互推理,支持语法约束输出 |
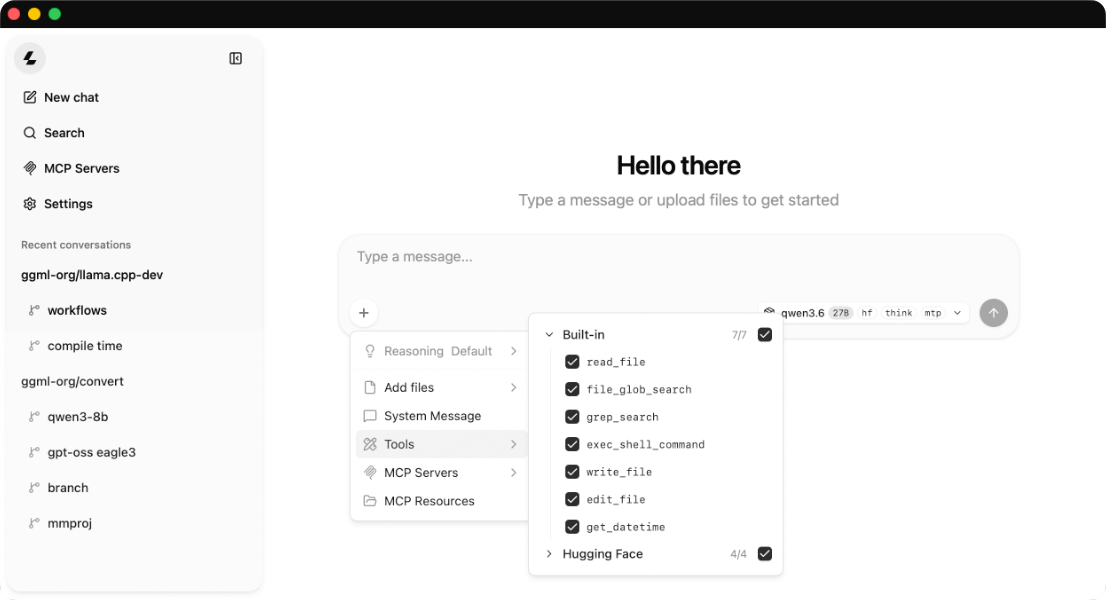
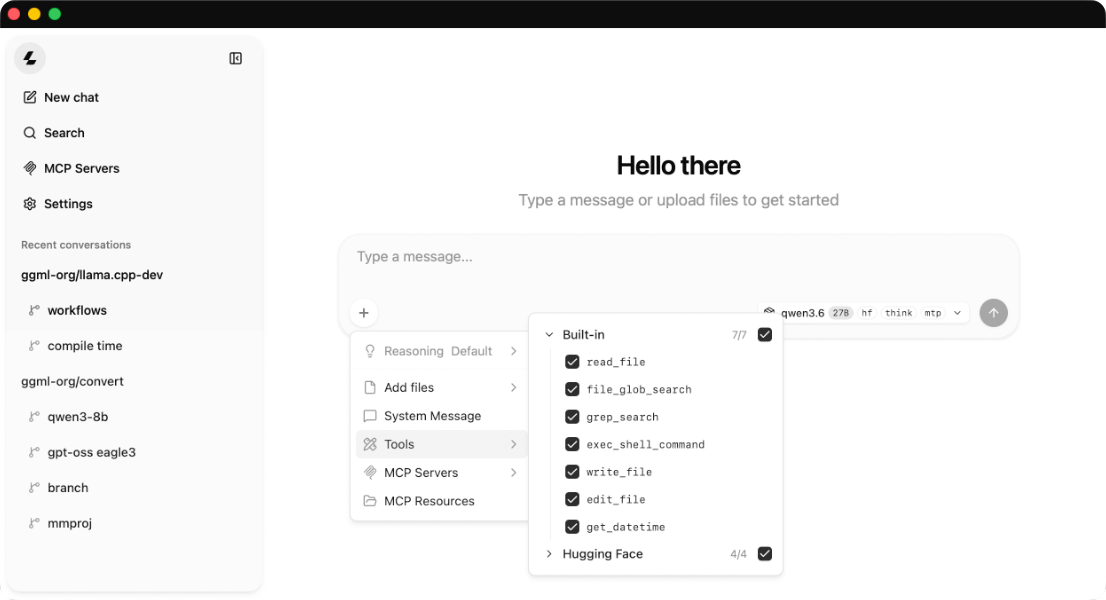
llama-server | OpenAI 兼容 HTTP API,自带 Web UI,支持并发/多模态/embedding |
llama-bench | 性能基准测试 |
llama-perplexity | 模型质量评估 |
llama-embedding | 文本嵌入生成 |
2026 年新动向
- 并入 Hugging Face:2 月核心团队加入,新模型适配从"天级"缩短到"小时级"。
- 决策模型(Decision Models):10 月新增
/v1/systemone端点,模型单次前向传播直接返回选项概率,用于路由、审核、Agent 步骤判断等场景,延迟仅 3~43ms。 - 生成式嵌入(Generative Embedding):利用 LLM 上下文处理能力增强检索鲁棒性。
- KV 缓存精细化调度:高频数据留显存、低频卸载系统内存,减少显存临界损耗。
- OpenVINO 后端预览:Intel 2026.1 版本引入,支持 Intel CPU/GPU/NPU 优化推理。
适合谁
- 想在本地/离线/边缘设备跑大模型的开发者
- 需要私有化部署、数据不出内网的企业
- 想深入理解量化、KV Cache、层卸载等底层机制的工程师
- Mac 用户(Metal 优化极佳,M 系列芯片跑 7B~13B 很流畅)
需要注意
- 版本迭代极快:采用 b+数字 构建号,几乎每天更新,生产环境建议锁定具体版本。
- 安全漏洞:已知 b8492 版本存在高危 RCE 漏洞(CVE-2026-34159),务必使用最新版本。
- 与 Ollama 的关系:Ollama 是对 llama.cpp 的高层封装,上手更简单但调参能力弱;学 llama.cpp = 学底层原理。